Sec. 04 · Inteligencia Artificial
Detección en tiempo real con YOLO
You Only Look Once: un modelo que mira cada fotograma una sola vez y decide, al instante, qué hay en él — sin depender de subir cada imagen a la nube para saberlo.
Todos conocemos qué es la IA, pero a lo mejor no te suena qué es YOLO. Te lo ponemos en contexto: la inteligencia artificial (IA) es el campo que estudia cómo hacer que un ordenador tome decisiones que normalmente requerirían visión o razonamiento humano — en Guardian Eye, decidir si hay una persona en un fotograma de vídeo. La pieza de IA que hace eso es YOLO, un modelo de visión por computador especializado en detección de objetos en tiempo real — no es un chatbot ni un asistente de texto, sino un modelo entrenado específicamente para analizar imágenes y señalar qué hay en ellas y dónde.
Para la parte de inteligencia artificial del dron se ha usado YOLO11, programando y entrenando el sistema directamente en la Raspberry Pi 5 que acompaña al dron a bordo, todo ello a través de un estricto pipeline (flujo de trabajo).
¿Qué es YOLO?
Una sola pasada, una decisión inmediata
YOLO analiza la imagen completa de una vez, en lugar de examinarla región por región, lo que lo hace lo bastante rápido para procesar vídeo en directo. Es la razón por la que se puede ejecutar a bordo del propio dron, en la Raspberry Pi 5 con el acelerador Hailo-8, sin depender de una conexión estable a Internet para saber si hay una persona en el encuadre.
Por qué en el borde, no en la nube
Subir vídeo en directo por un enlace 4G en zonas de montaña es lento y poco fiable. Procesando la detección directamente en la Raspberry Pi, el dron puede avisar de una posible detección aunque el enlace a la nube esté degradado o caído — coherente con la filosofía “edge-first” del resto del sistema. A esto se le llama edge computing: procesar los datos cerca de donde se generan, en lugar de enviarlos primero a un servidor remoto.
De dónde viene YOLO
YOLO (“You Only Look Once”) es una familia de modelos de detección de objetos en tiempo real, hoy mantenida por Ultralytics. Guardian Eye usa YOLO11, su versión más reciente, elegida por su equilibrio entre precisión y velocidad de inferencia en hardware modesto como una Raspberry Pi.
Qué es una “caja delimitadora”
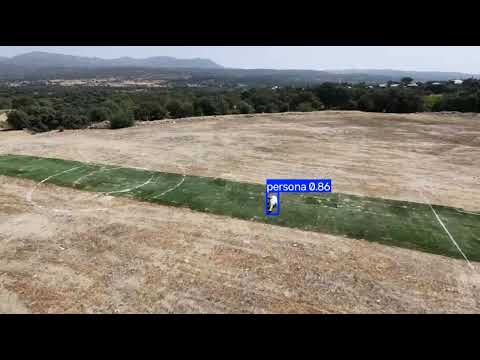
Cada detección se representa como una bounding box: un rectángulo definido por su centro, ancho y alto en píxeles, junto con un valor de confianza entre 0 y 1 que indica cuánto “cree” el modelo que ese rectángulo contiene realmente una persona.
YOLO y OpenCV cumplen papeles distintos y complementarios: YOLO se encarga de la inferencia y el análisis del fotograma —decidir qué hay y dónde—, mientras que OpenCV se usa para manipular la imagen en sí: leer el flujo de vídeo, recortar o redimensionar cada fotograma y dibujar la propia bounding box sobre él.
Cómo se ajusta en la práctica
El pipeline se puede afinar sin tocar el modelo: un umbral de confianza (0,5 por defecto) descarta detecciones poco fiables, un muestreo de fotogramas —analizar uno de cada seis, configurable— evita saturar la Raspberry Pi, y el margen anti-spam ya mencionado evita repetir la misma alerta en fotogramas consecutivos. Si hiciera falta más margen de cómputo, el modelo también se puede exportar a formatos de inferencia más ligeros que PyTorch — ONNX o NCNN — sin cambiar el resto del pipeline.
Estado real del proyecto
Un pipeline validado, un modelo en construcción
¿Qué es un «pipeline» de IA? En aprendizaje automático, un pipeline es la secuencia ordenada de etapas por las que pasan los datos y el propio modelo, desde que se recogen los primeros ejemplos hasta que ese modelo toma decisiones reales en producción — cada etapa alimenta a la siguiente, y un cambio en una (más datos, un nuevo etiquetado) obliga normalmente a repetir las de después. No es una particularidad de este proyecto: es el vocabulario estándar con el que se describe cualquier sistema de IA, desde un TFG hasta un producto comercial.
Prueba de concepto ya validada
El primer pipeline YOLO11 completo se construyó y validó con Roboflow sobre un dataset pequeño de detección de fruta (~300 imágenes aumentadas), entrenado en 2 h 40 min en CPU, con inferencia comprobada sobre vídeo real de vuelo. Código en yolo-pipeline-test.
Dataset de personas cerrado en 717 imágenes
El conjunto final combina imágenes propias grabadas en vuelos reales en el Club Alas de Galapagar, 70 vídeos de uso libre de Pexels y 125 imágenes seleccionadas de un dataset público de búsqueda y rescate (de cerca de 1.980 disponibles, licencia CC BY 4.0) para cubrir posturas poco representadas —personas tumbadas o sentadas—. El resultado son 717 imágenes bajo una única clase (“persona”): 540 de entrenamiento, 88 de validación y 89 de prueba.
Métricas reales del modelo final (yolo11n)
0,659
Recall
0,640
mAP@50
0,684
Precisión
0,205
mAP@50-95
Sobre el acelerador Hailo-8 (26 TOPS), ese mismo modelo corre de forma estable a 26,8 FPS, con solo 14,2 ms de latencia por fotograma y un uso de CPU de apenas el 28 %. Un recall de 0,659 significa, con honestidad, que a día de hoy una de cada tres personas del conjunto de prueba no se detecta: es un modelo de prueba de concepto que valida el pipeline completo de extremo a extremo, pensado como apoyo a la verificación visual del operador — no como sustituto de su criterio.
Formato del mensaje de detección
Lo que YOLO reporta — y lo que no
YOLO no entrega coordenadas geográficas de la persona, sino su posición en píxeles dentro de la imagen. El sistema registra la posición del dron en el instante de la detección, no la localización exacta de la víctima —eso requeriría georreferenciación, una línea de trabajo futura. Tampoco hay seguimiento individual entre fotogramas: solo un margen anti-spam (por defecto, 5 s) para no repetir la misma alerta.
{
  "confianza": 0.0-1.0,
  "caja": { "cx": px, "cy": px,
            "w": px, "h": px },
  "resolucion": { "ancho": px, "alto": px },
  "dron": { "lat": ..., "lon": ..., "alt_rel": ... },
  "foto": "deteccion_XXXX.jpg",
  "timestamp": "AAAA-MM-DDTHH:MM:SSZ"
}
Formato real tal cual lo construye deteccion.py — el campo «foto» es solo el nombre del fichero guardado en el propio dron, no la imagen; el resto del recorrido de esa alerta (buffer local, MQTT, InfluxDB) está en Datos e IoT, y cómo se graban y transmiten el vídeo y las fotos, en Vídeo.
Ver las detecciones en acción sobre vídeo real de vuelo.
Última actualización de estado: journal público del proyecto, agosto de 2026.